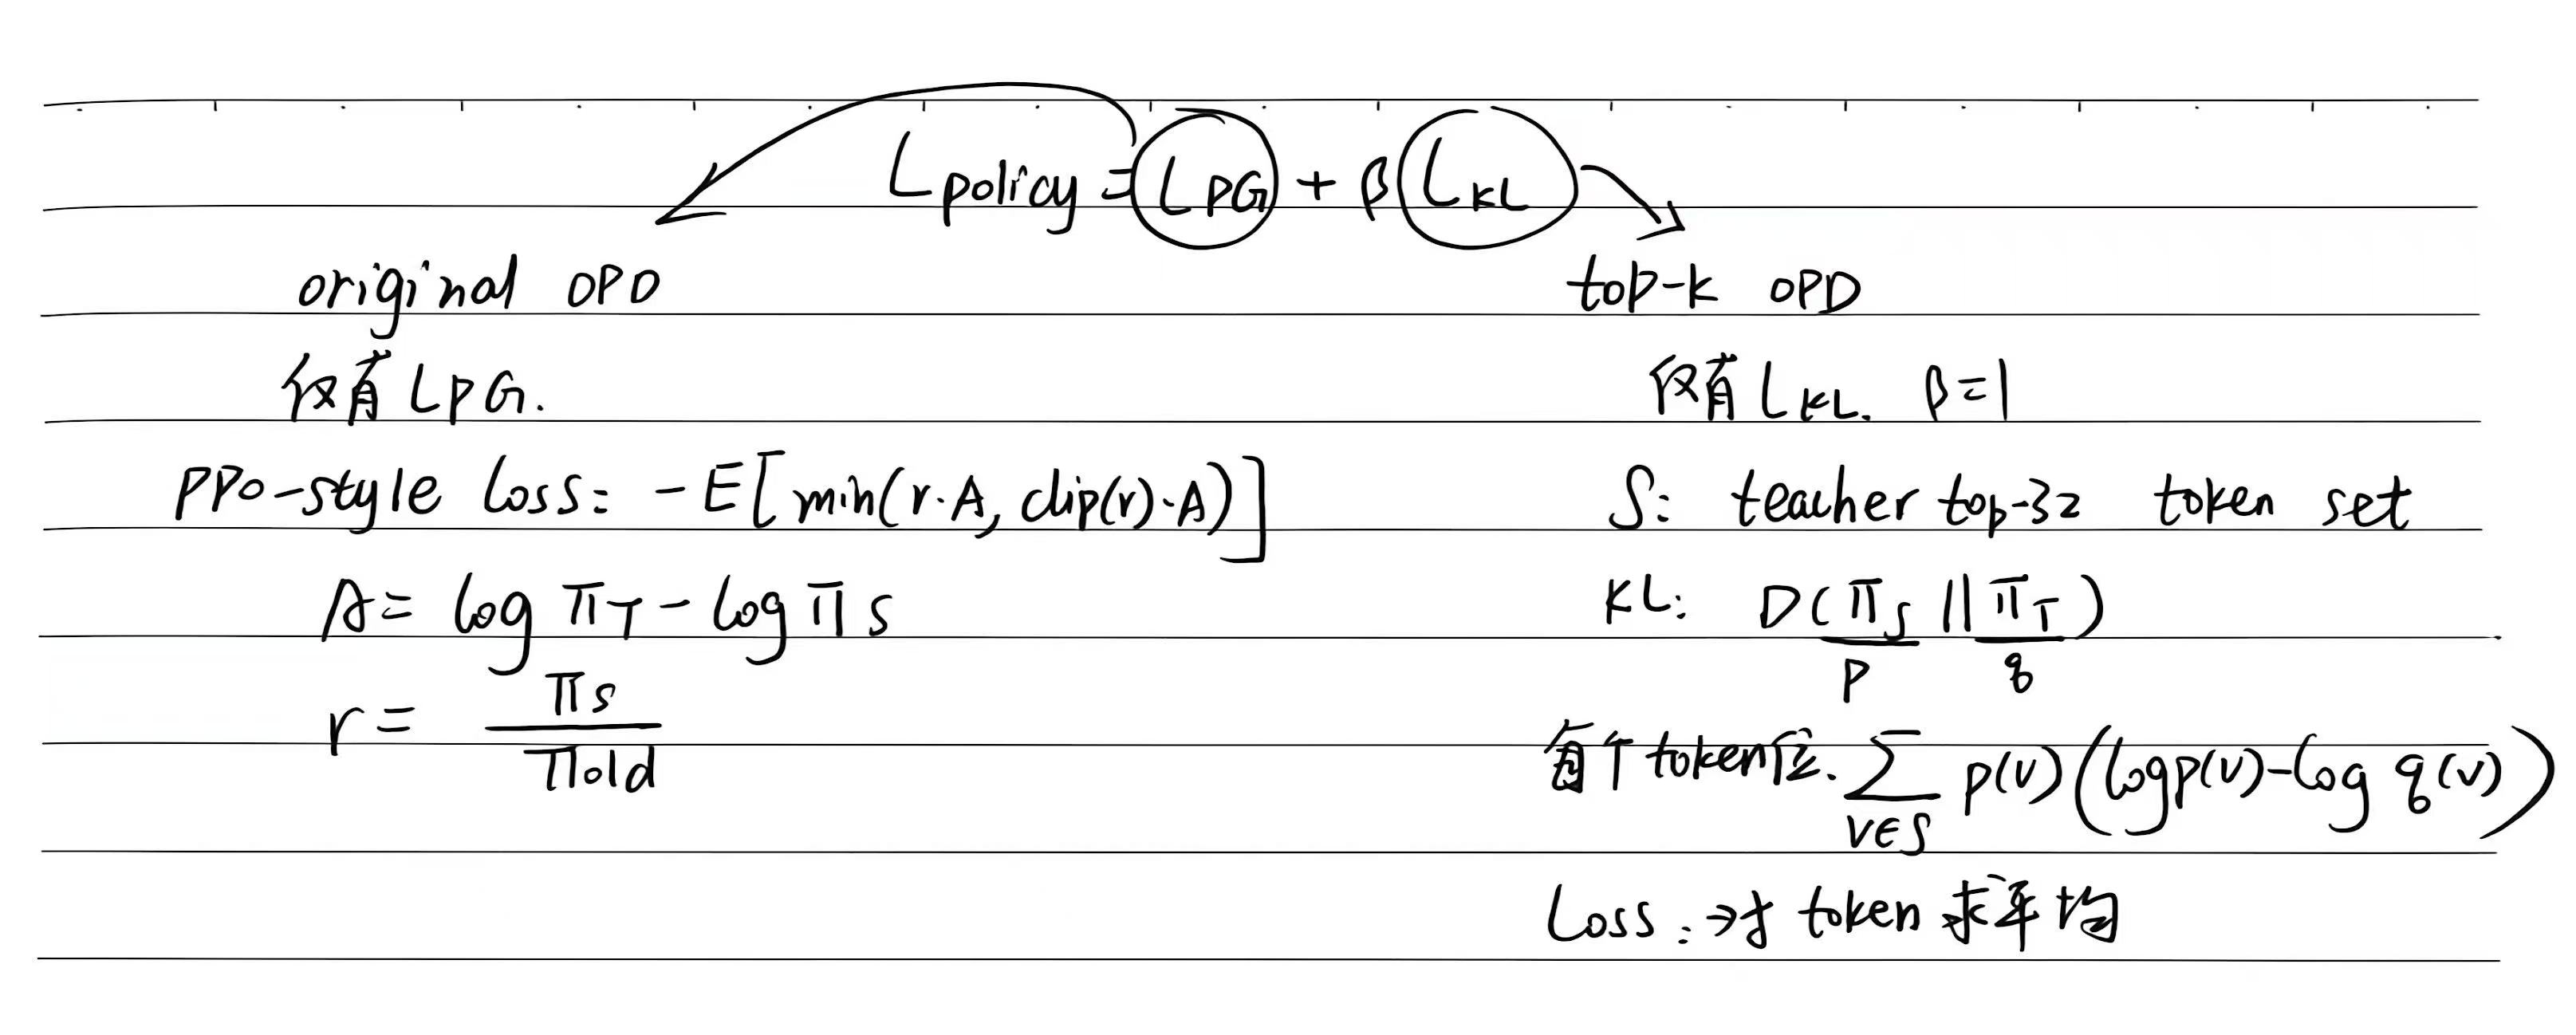改进的 GRPO 后训练大模型

在 DeepScaleR 数学数据上对比原始 GRPO 与改进方案,通过难度预测器筛选更合适的题目,并结合历史数据重用减少新采样量,维持训练 batch 的有效性。

数据集

  • 训练集:DeepScaleR,共 10,240 条数学题
  • 测试集:GSM8K、MATH500、Minerva Math、OlympiadBench
  • 评价指标:四个 benchmark accuracy 的等权平均

模型

Qwen2.5-Math-1.5B Base

改进方案

保留 GRPO 的 group-relative advantage 训练思路;在 epoch 0 后使用 256 fresh prompts + 256 replay prompts,并用难度预测器优先选择目标成功率附近的样本。

结果

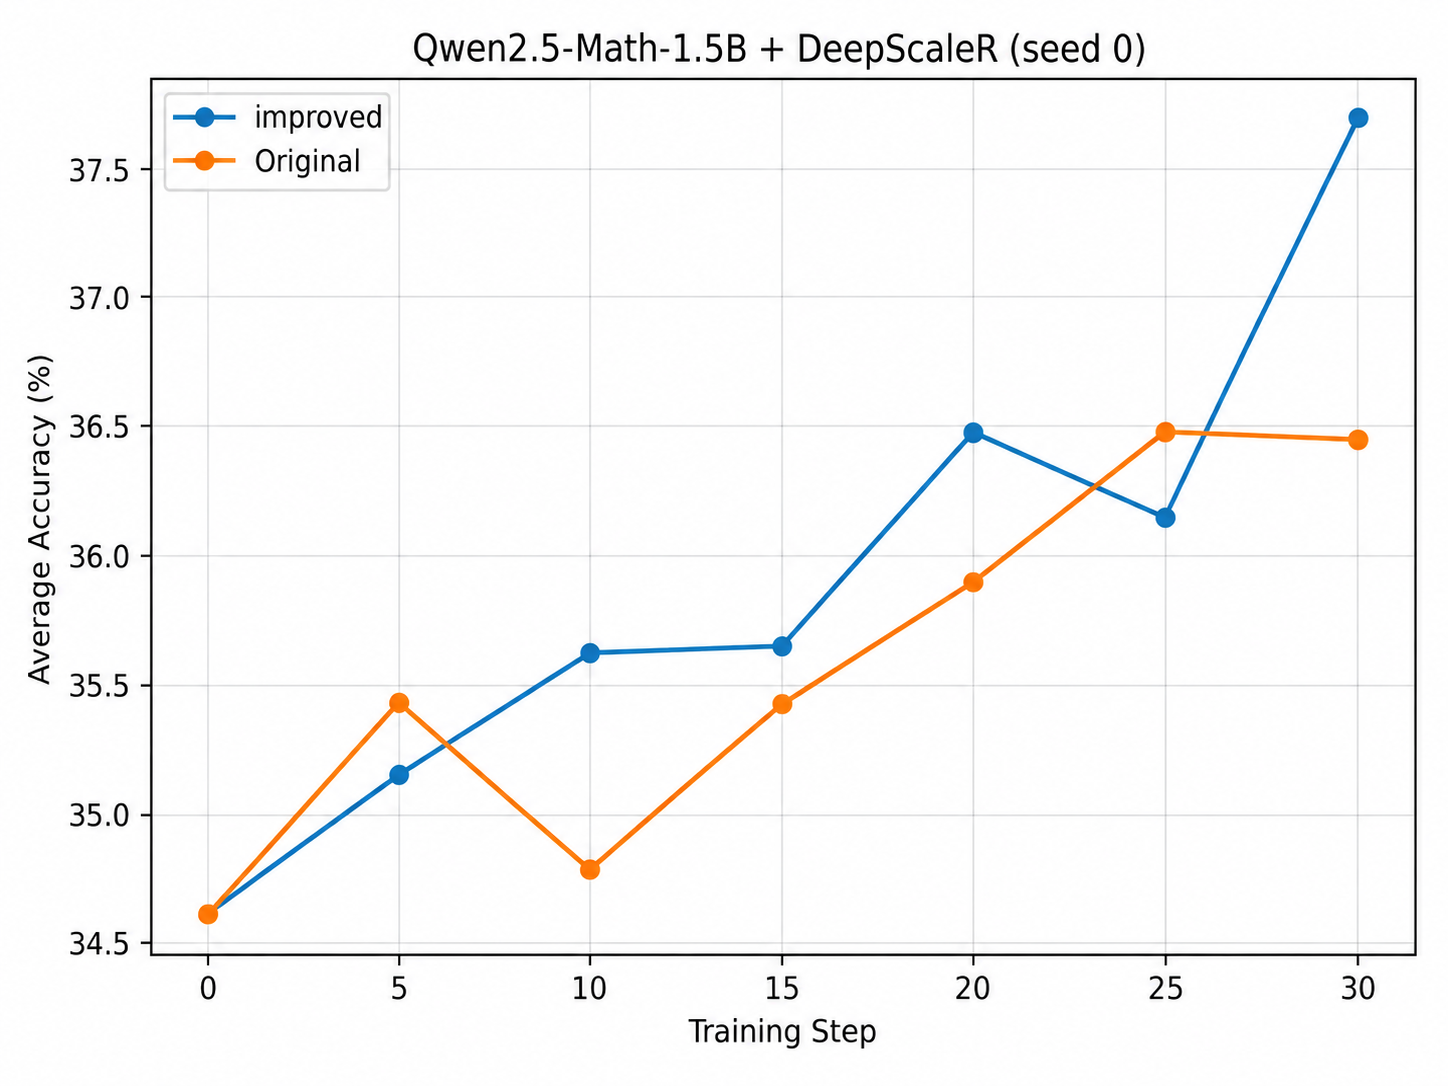
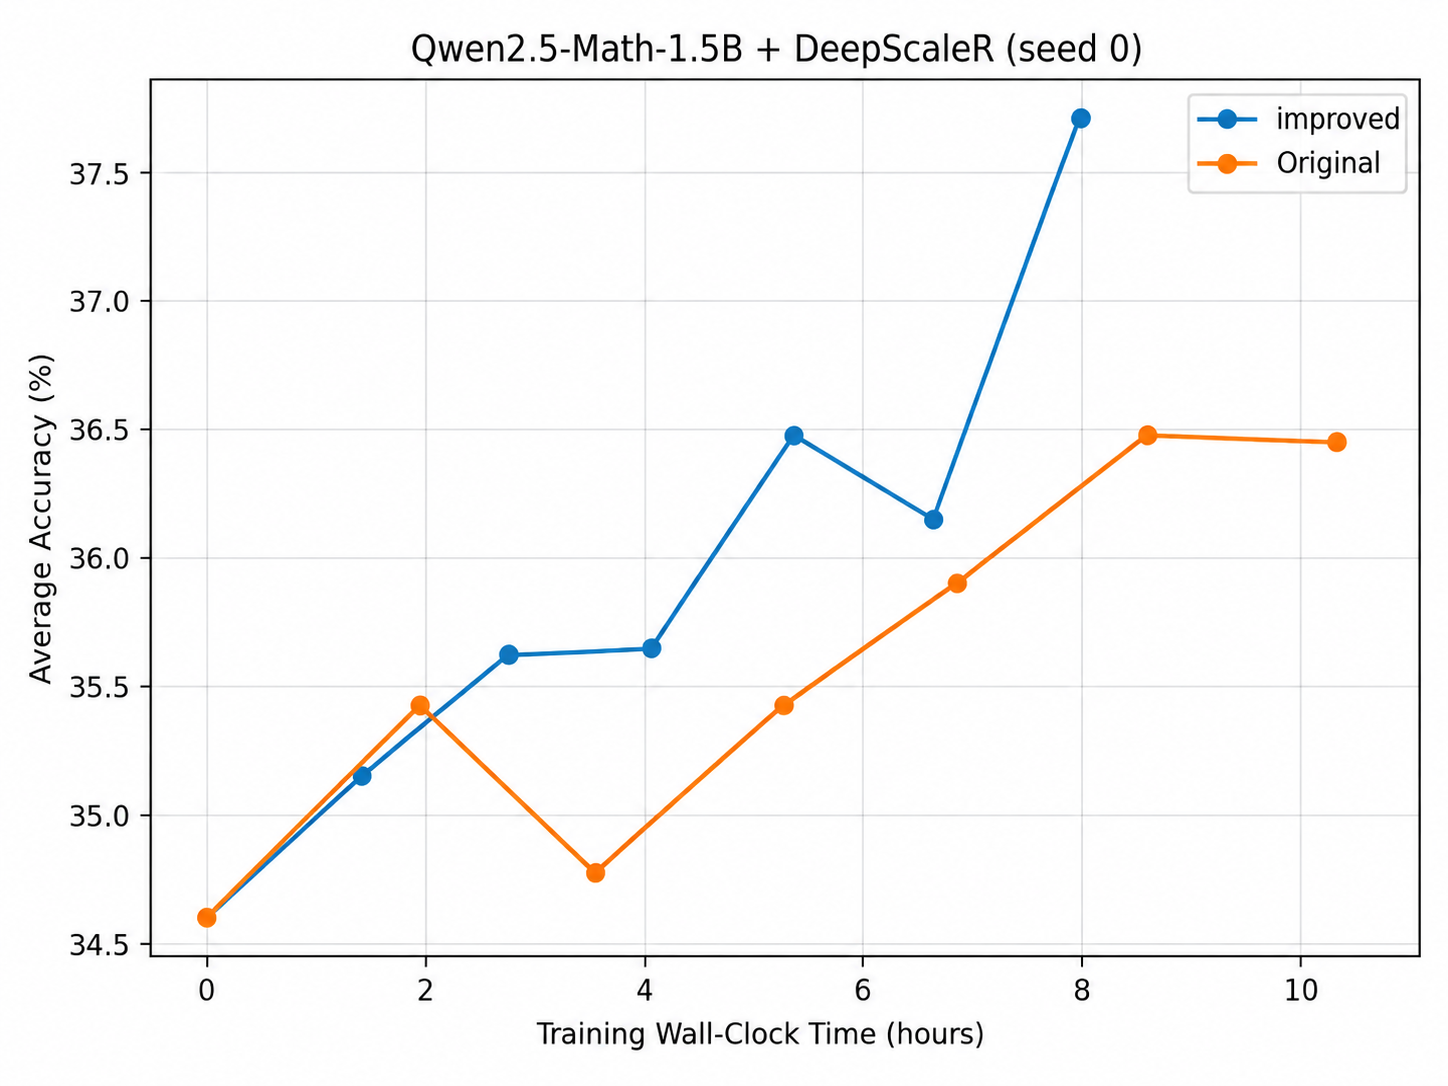
下方曲线显示,改进方案在训练步数和 wall-clock time 两个维度上整体更快提升,最终平均准确率约 37.7%,高于原始 GRPO 的约 36.45%

核心参数

GPU
4 x A100
Total Steps
30
Train Batch
512 prompts / step
Rollout Num
8
Max Prompt
1024 tokens
Max Response
3072 tokens
Learning Rate
1e-6
PPO Mini-batch
64
Micro Batch / GPU
4
Fresh / Replay
256 + 256
Replay Buffer
512
ref_size
256
改进 GRPO 与原始 GRPO 按训练步数对比的平均准确率曲线
不同 training step 下的平均准确率对比
改进 GRPO 与原始 GRPO 按训练时间对比的平均准确率曲线
不同训练时间下的平均准确率对比

面向数学推理的 On-Policy Distillation 实验

基于 verl 框架复现并改造 OPD 训练流程,教师为 Qwen2.5-Math-1.5B-Instruct、学生为 Qwen2.5-1.5B-Instruct 的组合训练稳定

模型

Teacher
Qwen2.5-Math-1.5B-Instruct,作为数学推理能力更强的密集监督来源。
Student
Qwen2.5-1.5B-Instruct,训练前在 AIME 与 held-out 测试集上表现较弱。
对齐处理
将学生聊天模板调整为与教师一致,减少格式差异对蒸馏信号的干扰。

数据集

训练集
ByteDanceTsinghua-SIA/DAPO-Math-17k,抽取不同的 1600 条;实验每 step 采样 8 prompts,每个 prompt 生成 group_size = 8,因此每步约 64 条 student rollout。
测试集 1
AIME,用于观察高难数学题上的 pass@1 变化;教师基线约 3/30。
测试集 2
held-out-200,从 DAPO-Math-17k 未用于训练的题目中抽取不同的 200 道;教师基线约 40.5%。下图图注中也称为“math-dapo”。

损失函数设计

Original OPD 的损失函数采用 PPO style,仅由 L_PG 构成;Top-K OPD 损失函数仅由 L_KL 构成,损失函数均为反向 KL形式。

Original OPD 与 Top-K OPD 的损失函数设计公式

实验结果分析

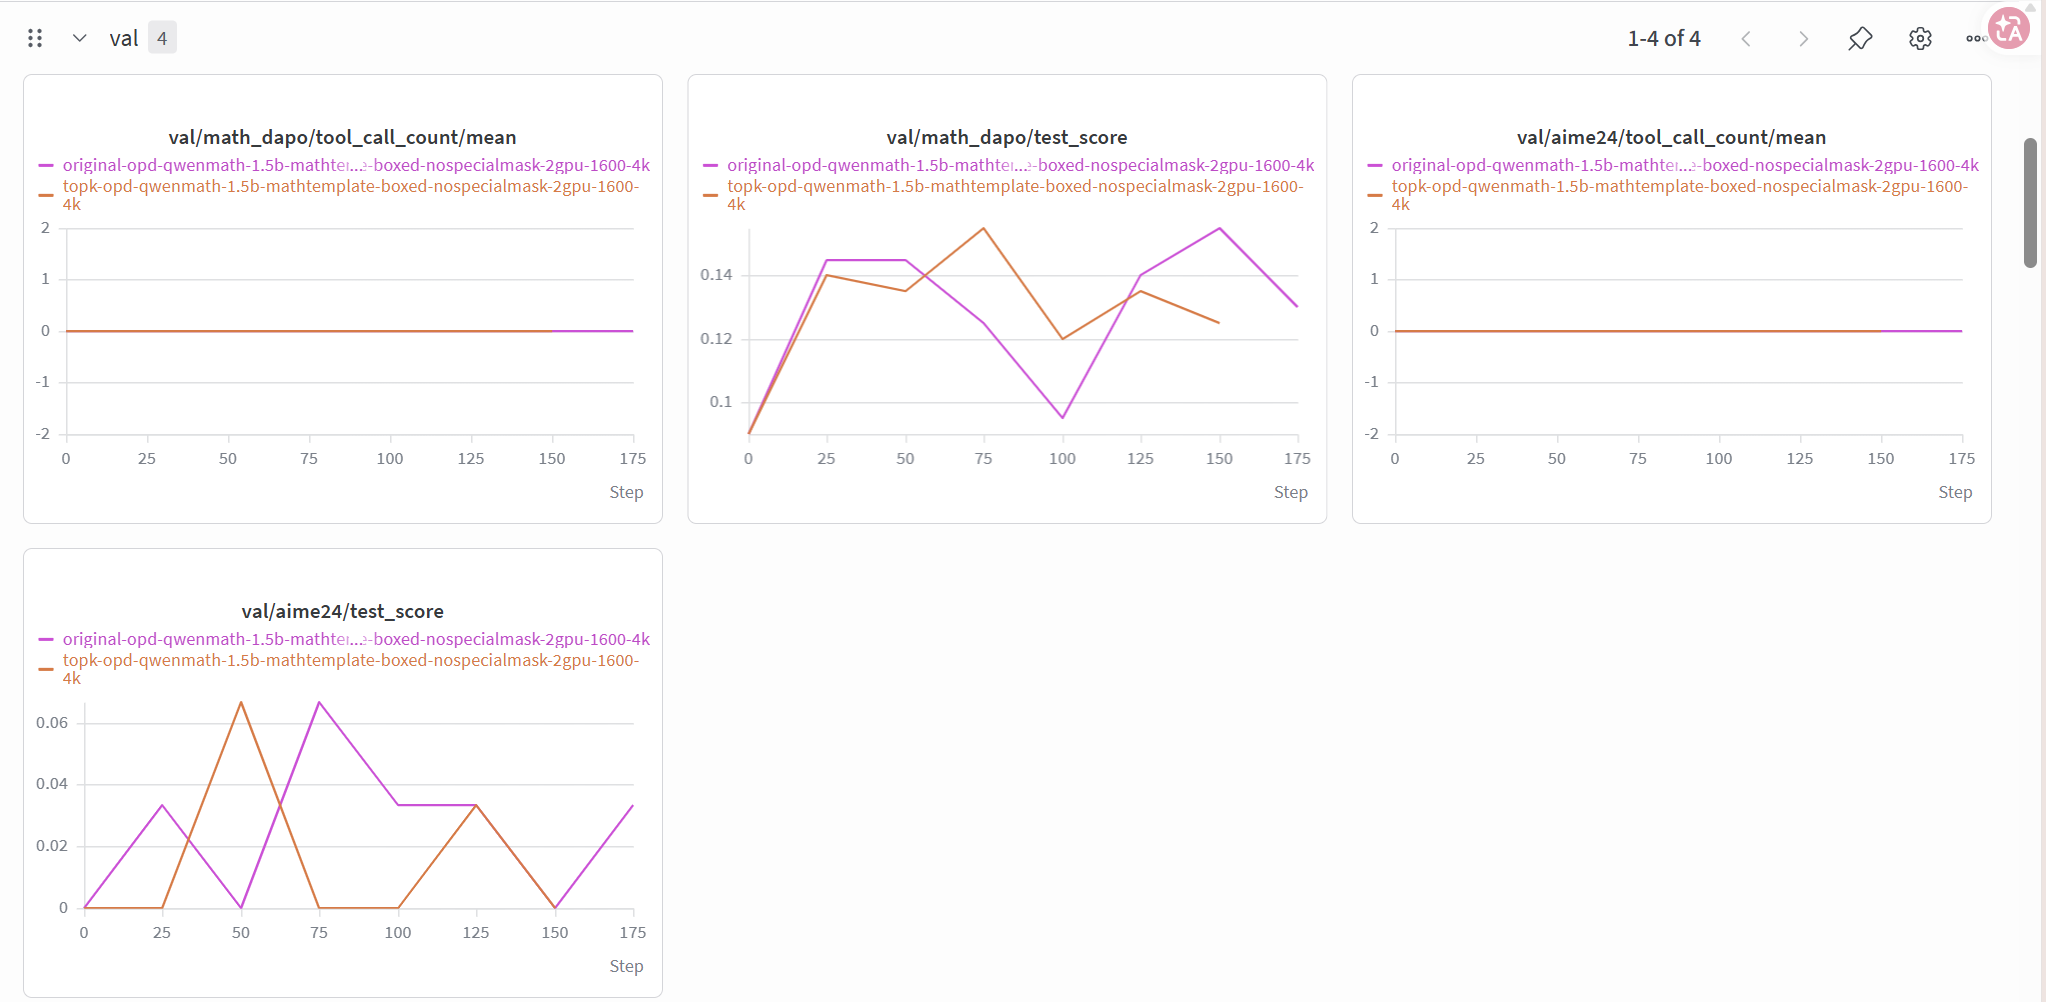
训练后,学生模型在 DAPO-Math held-out 与 AIME24 上的最好准确率分别由约 9% 提升至 15.5%、由 0% 提升至 6.67%。在前 150 step 内,Teacher Top-K OPD 与 Original OPD 的验证表现基本持平,最终准确率尚未显著超过 Original OPD。

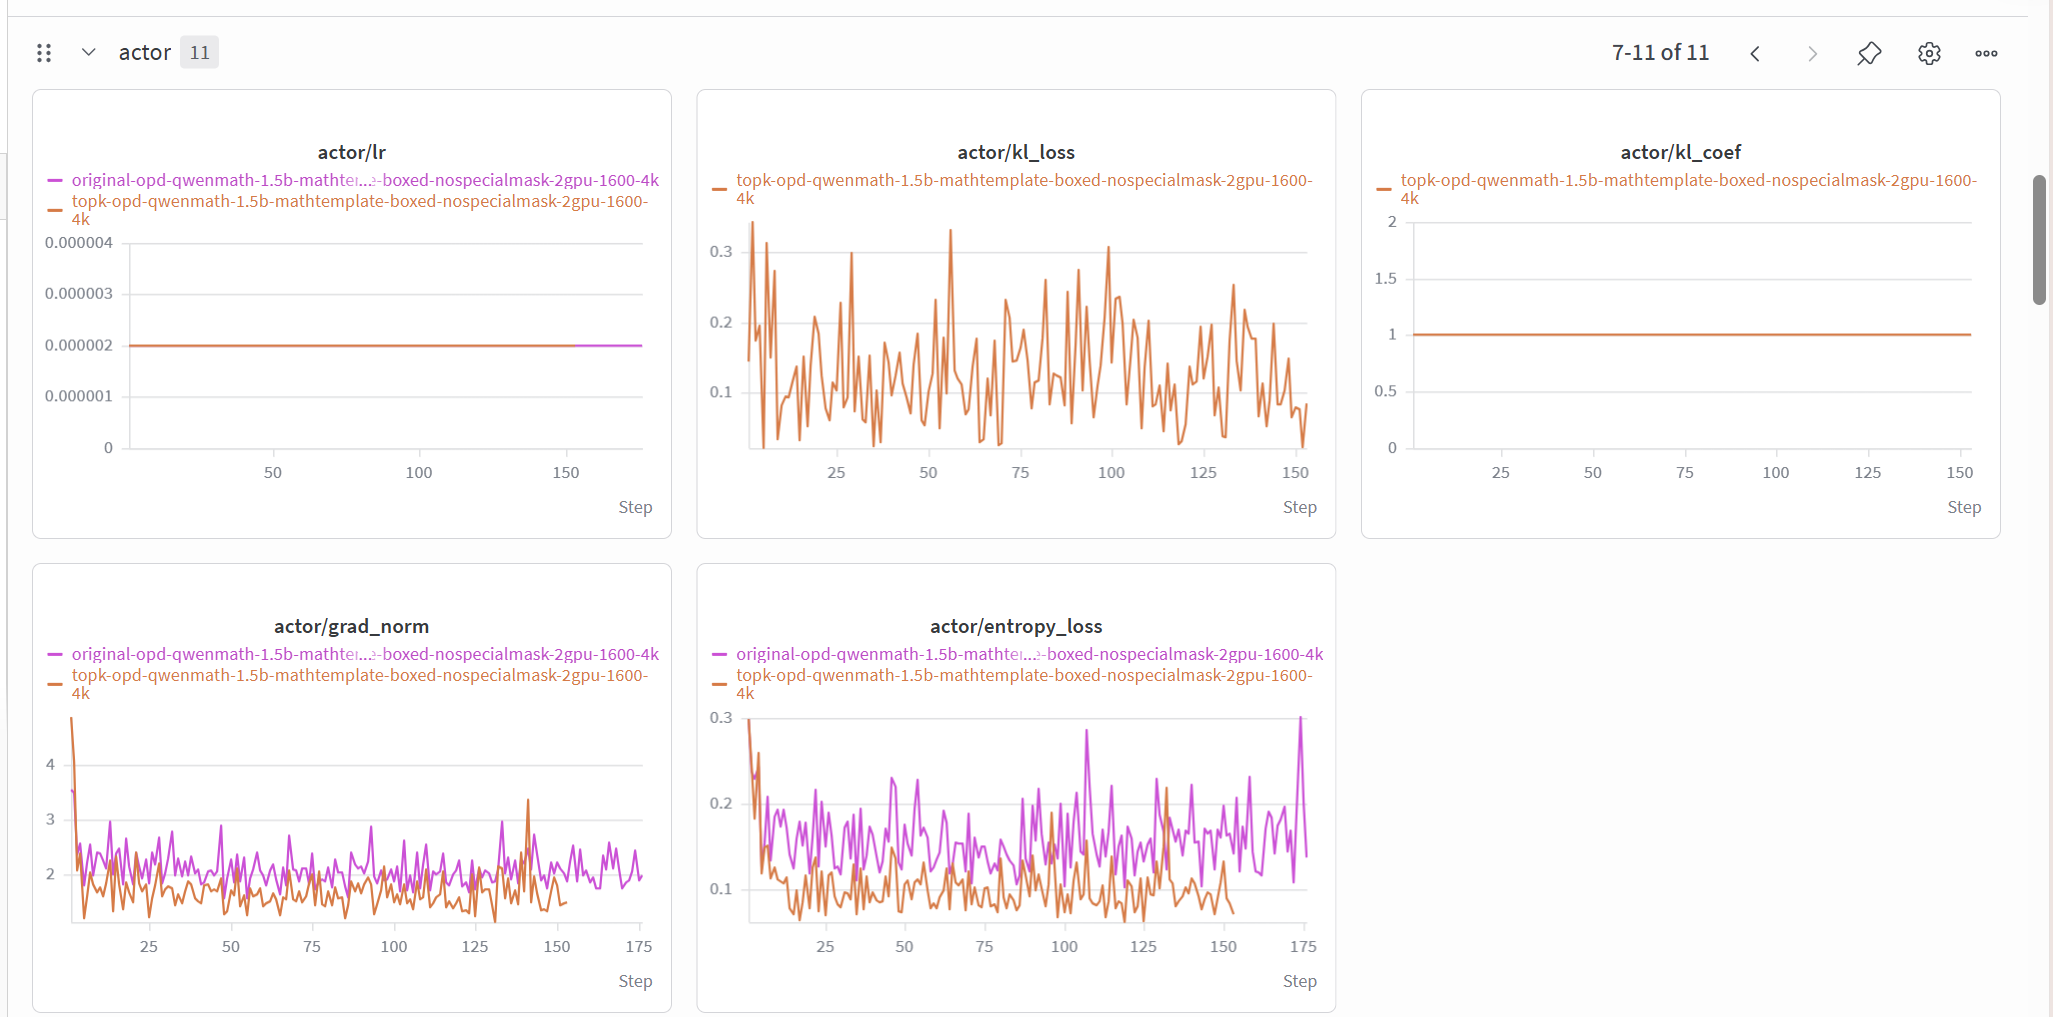
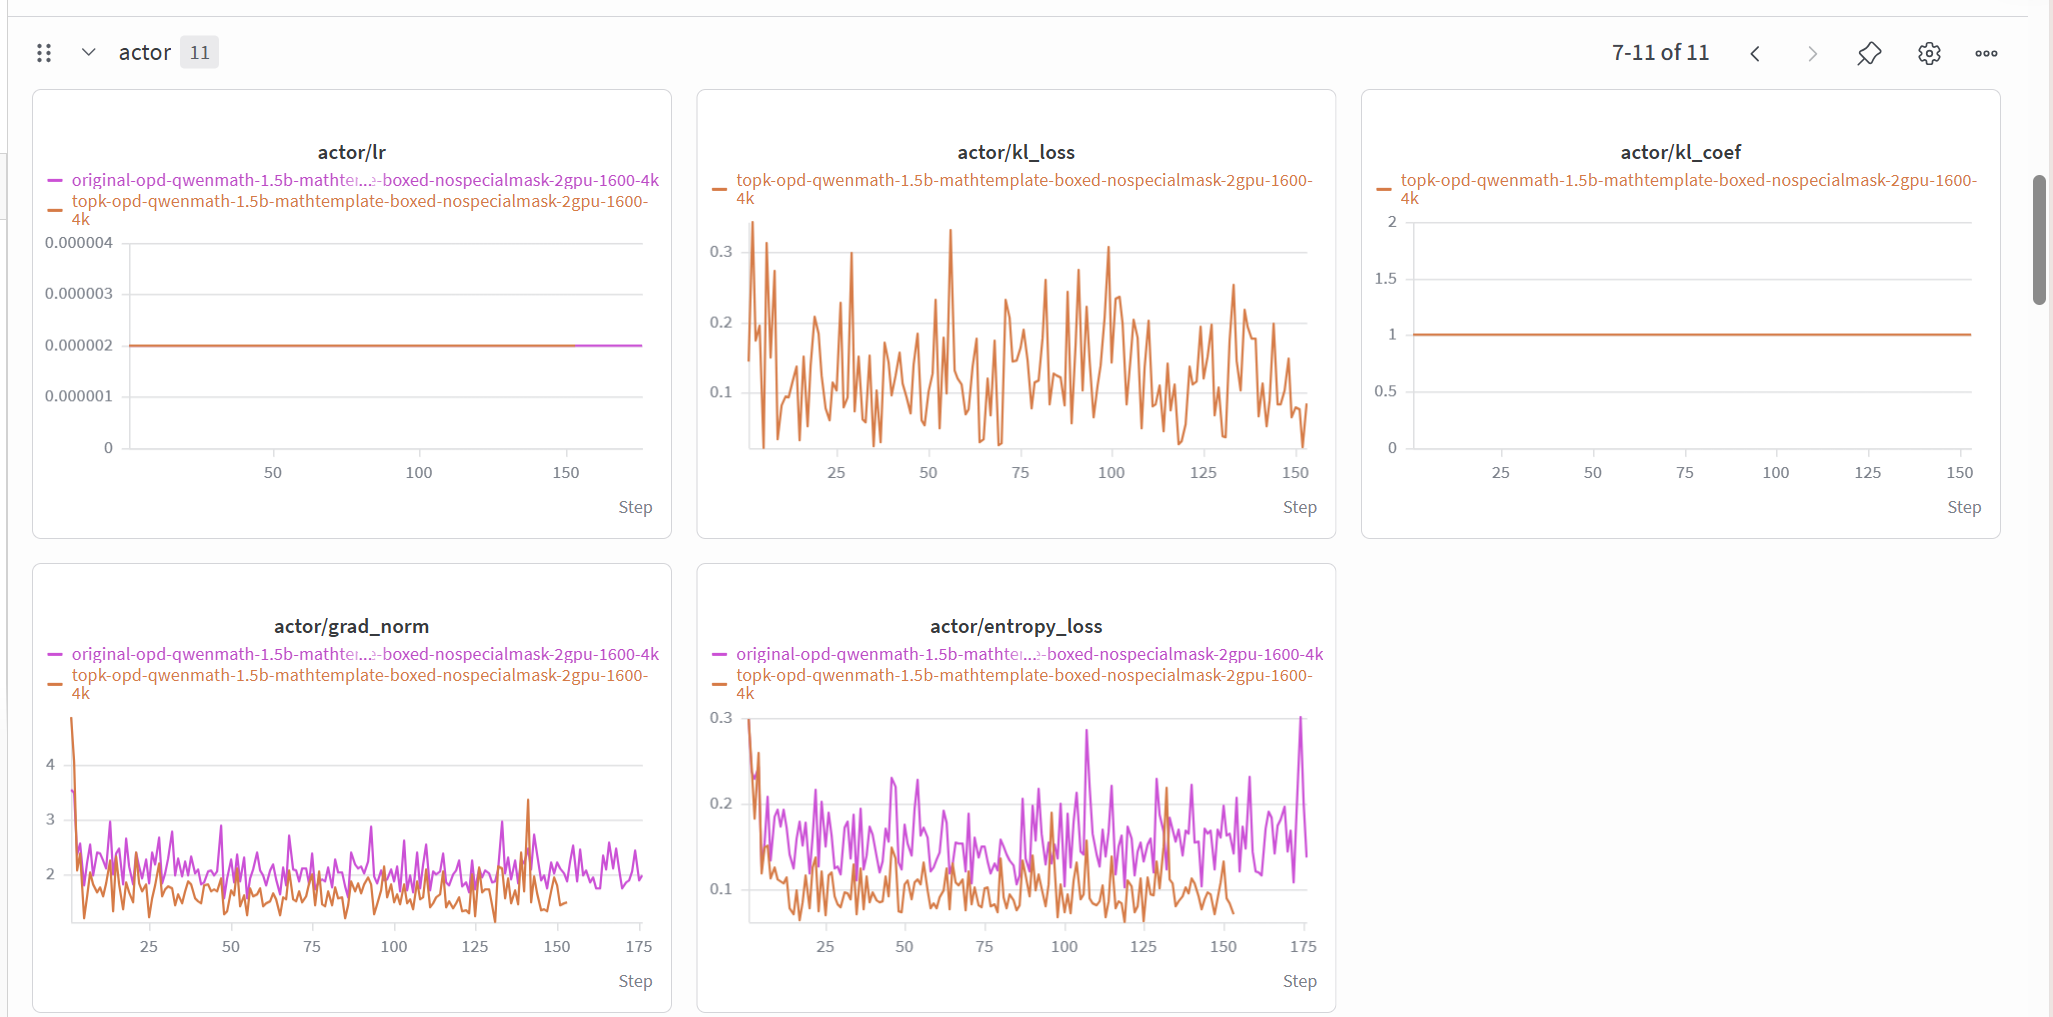
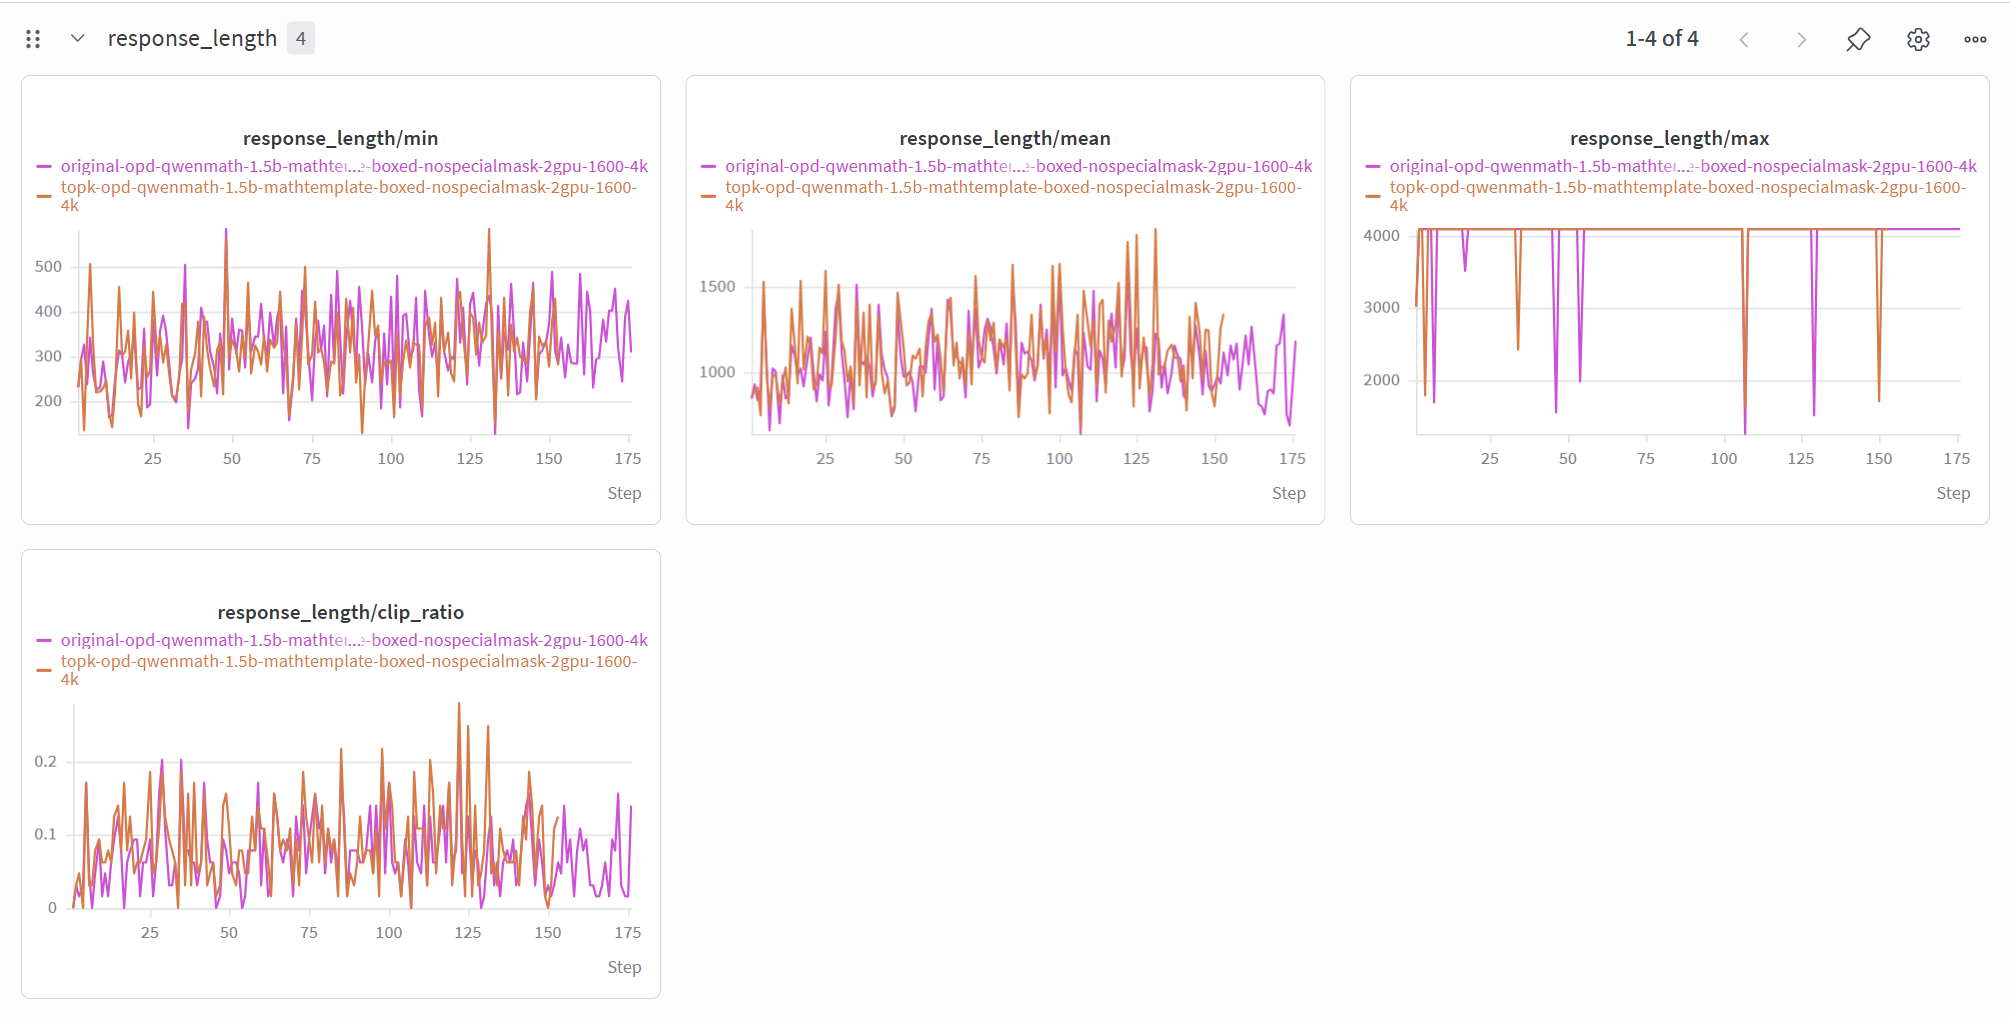
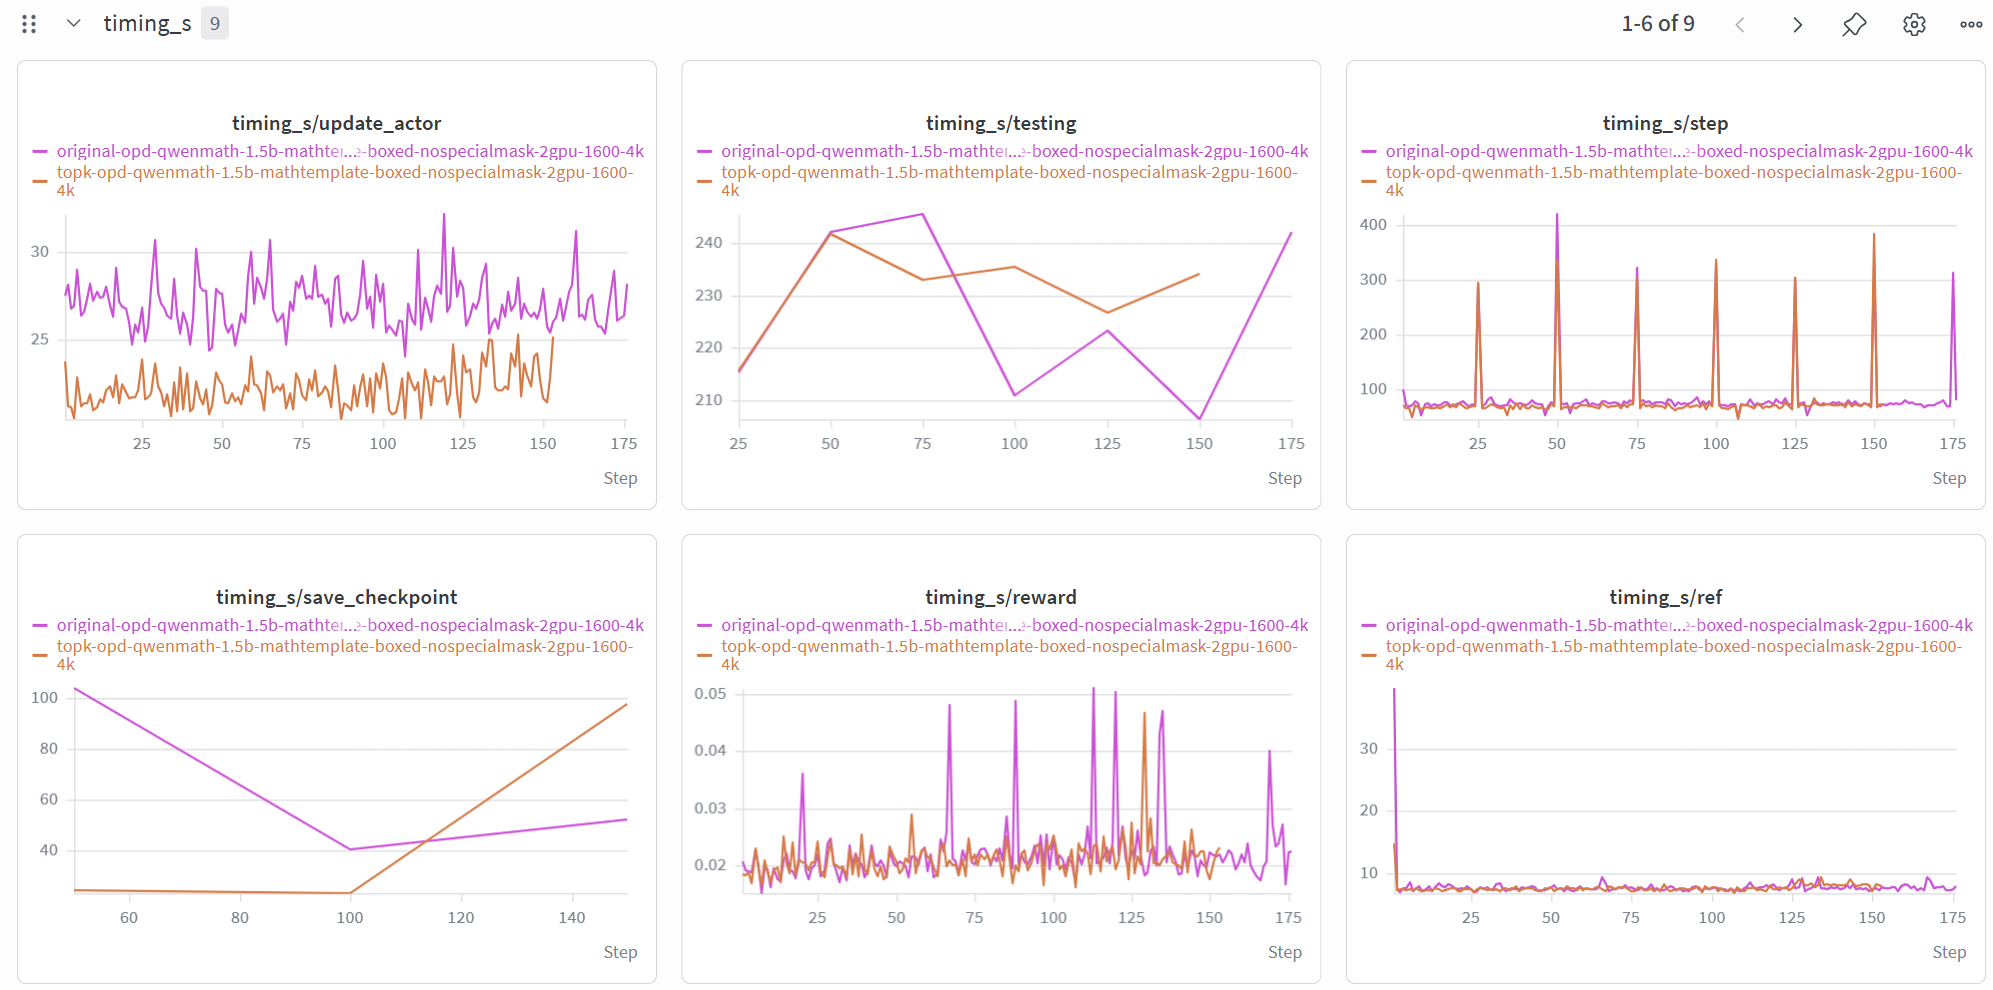
但 Top-K 版本获得了更低的 student entropy、rollout/train probability discrepancy 与 actor 单 token 更新时间,说明筛选教师高置信 token 后,蒸馏信号更集中,学生更新也更轻量。结合 response length 与 timing 曲线看,训练过程中回答长度没有爆炸,整体 step 用时与 Original OPD 接近,主要改进体现在学生模型更新阶段。

Original OPD 与 Top-K OPD 在两个测试集上的 validation 结果
AIME24 与 math-dapo 两个测试集上的 validation 结果
Original OPD 与 Top-K OPD 的 actor 指标第一组
Original OPD 的 loss 来源于 L_PG,Top-K OPD 的 loss 来源于 L_KL
Original OPD 与 Top-K OPD 的 actor 指标第二组
Original OPD 的 loss 来源于 L_PG,Top-K OPD 的 loss 来源于 L_KL
训练过程中的回答长度指标
训练过程中回答长度稳定,没有出现长度爆炸
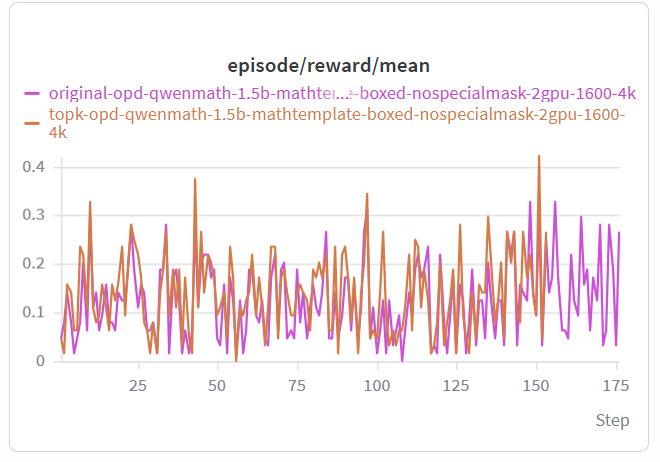
训练过程中的 episode reward mean 指标
🤔如果每个 step 的训练 prompt 难度差不多相等,这个指标或许会有上升趋势
Original OPD 与 Top-K OPD 的 timing 指标对比
Top-K OPD 每一步更新学生模型用时更低,但每一步整体上和 Original OPD 差不多