首次建立缓存
first 模式扫描页面顶部已有图片,把图片名称写入 JSON,作为后续判断新增内容的基准。
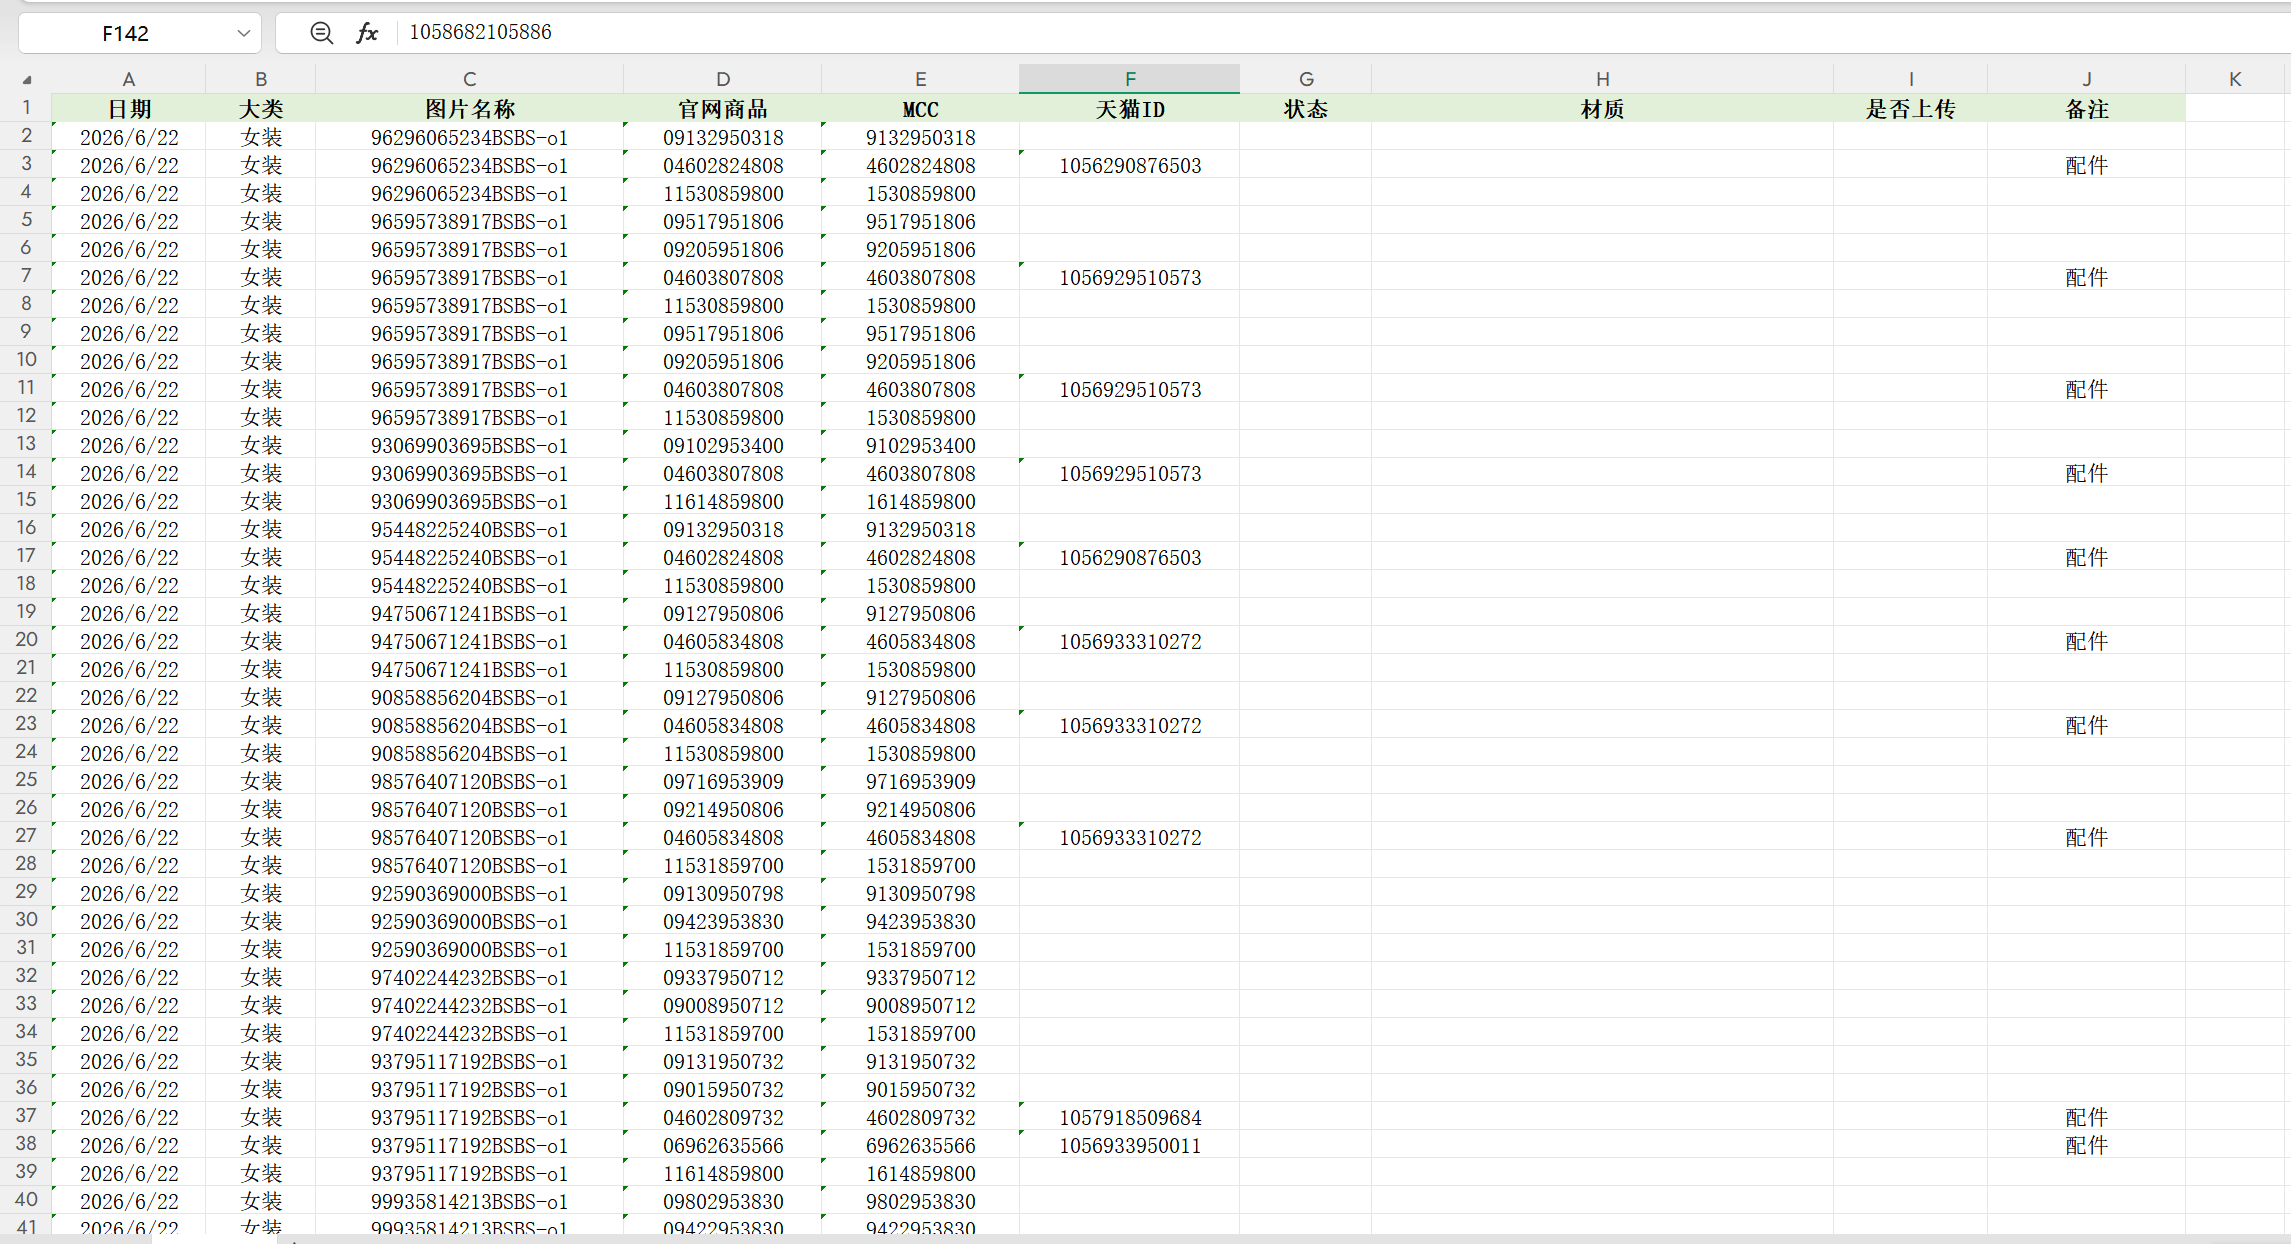
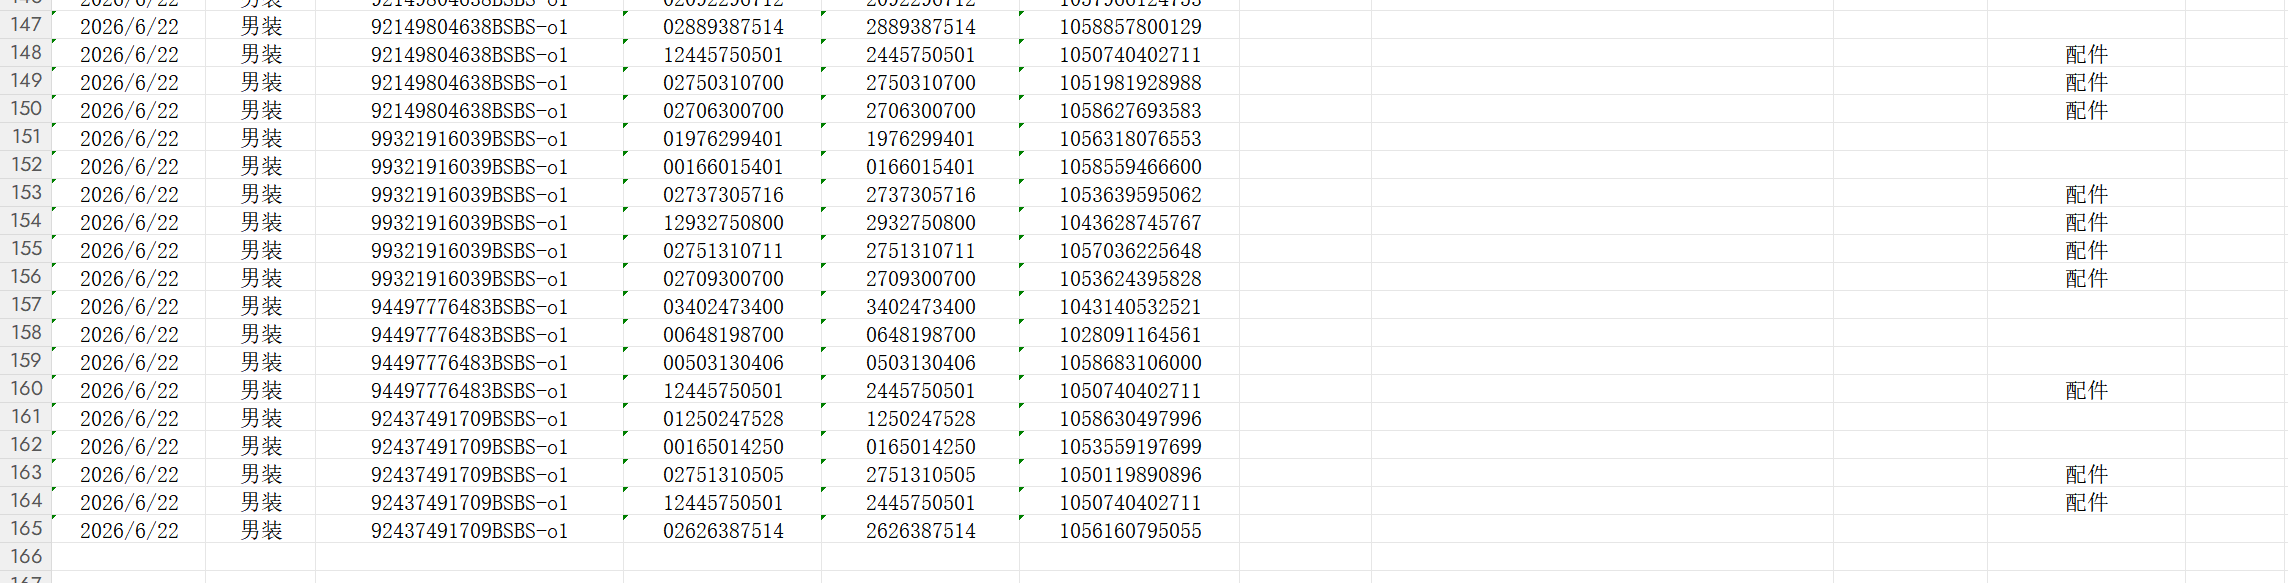
这个项目把原本需要人工进入官网、逐张核对主图、下载素材、搜索天猫 ID 的流程,改造成可定期运行的监测脚本。最终输出给运营侧的是一张可继续处理的 Excel:包含监测日期、男女装分类、主图名称、官网商品、MCC、天猫 ID 和配件备注。
我把任务拆成“监测更新”和“处理新增内容”两段:先判断官网顶部是否出现新主图,再进入详情页提取主图、搭配商品和后续运营字段。
first 模式扫描页面顶部已有图片,把图片名称写入 JSON,作为后续判断新增内容的基准。
monitor_only 模式读取缓存,从页面顶部向下采集图片,直到遇到上次缓存的第一张图。
用浏览器自动化模拟人工滚动,每次滚动后等待图片加载,避免直接抓源码漏掉延迟出现的图片。
用官网货号生成 MCC,再匹配天猫全店表,补齐商品 ID、类目和配件备注。
下方保留原始 SOP 的关键截图,同时写清楚脚本对应做了什么。这样展示时既能看到业务原貌,也能看到我如何把它抽象成程序流程。
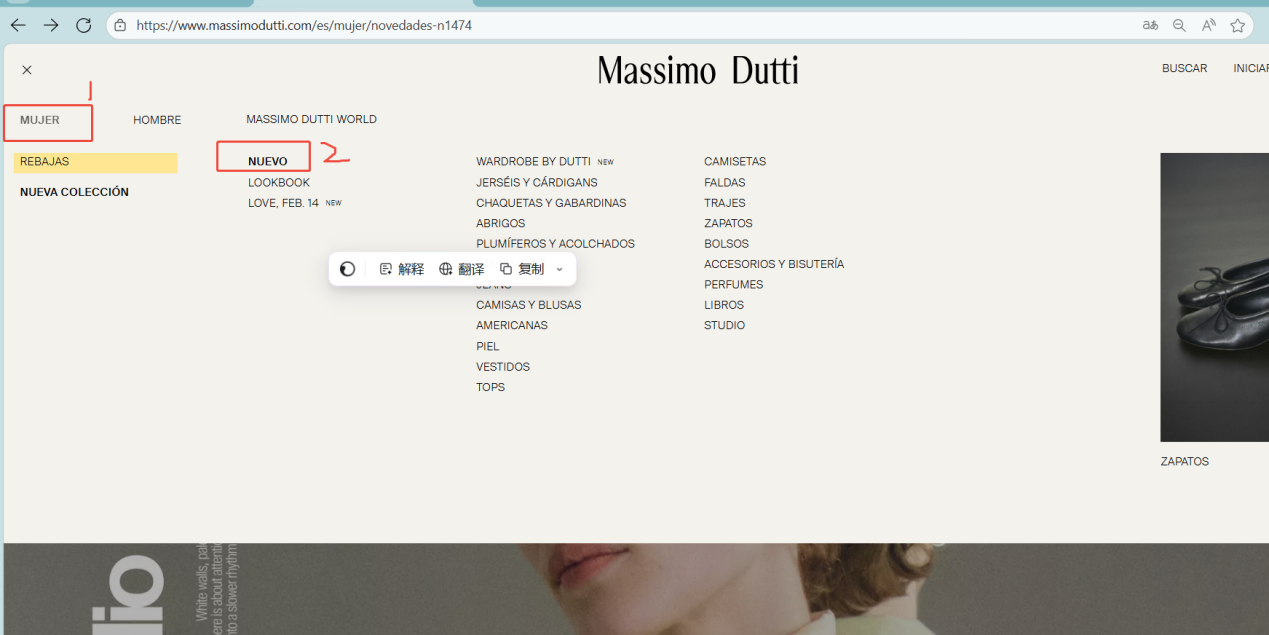
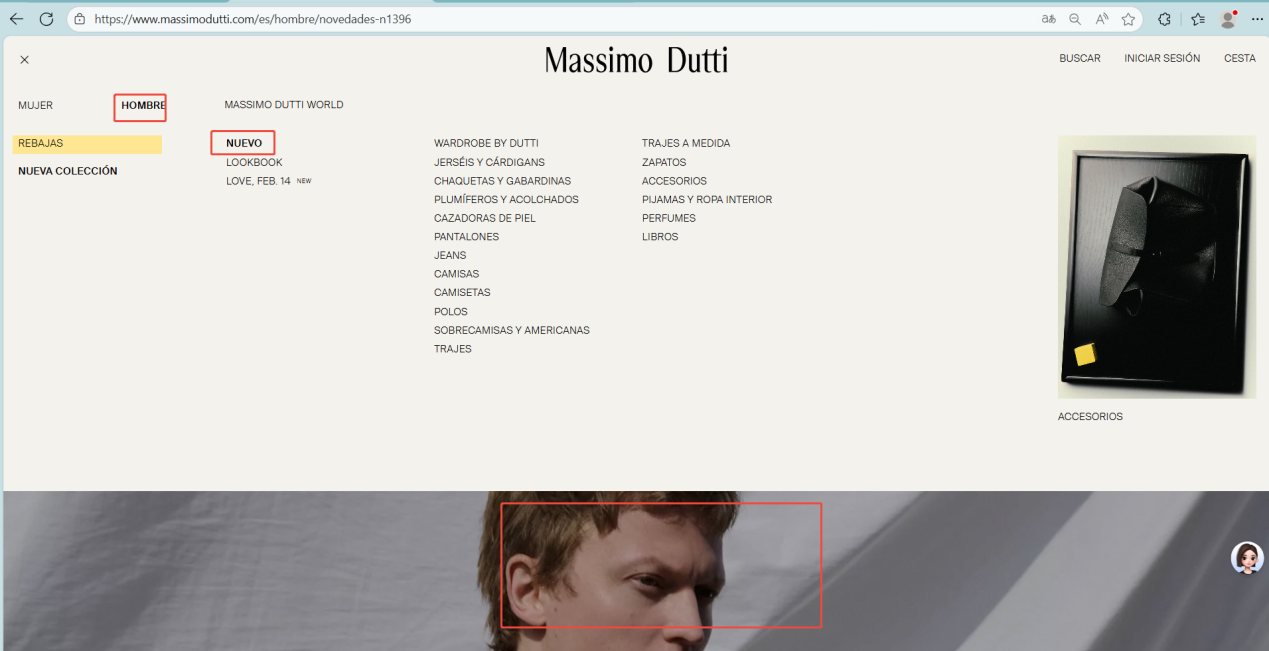
人工流程先进入 Massimo Dutti 官网,分别选择女装或男装,再点击 Nuevo 新品页。脚本中对应为两套入口配置:女装 URL、男装 URL、缓存文件和输出目录分开管理。
人工会从列表页大图逐张进入详情页。脚本不会全站扫描,而是从顶部向下滚动,并用图片名称与缓存比对;缓存中第一张旧图之前出现的内容,判定为本次新增。
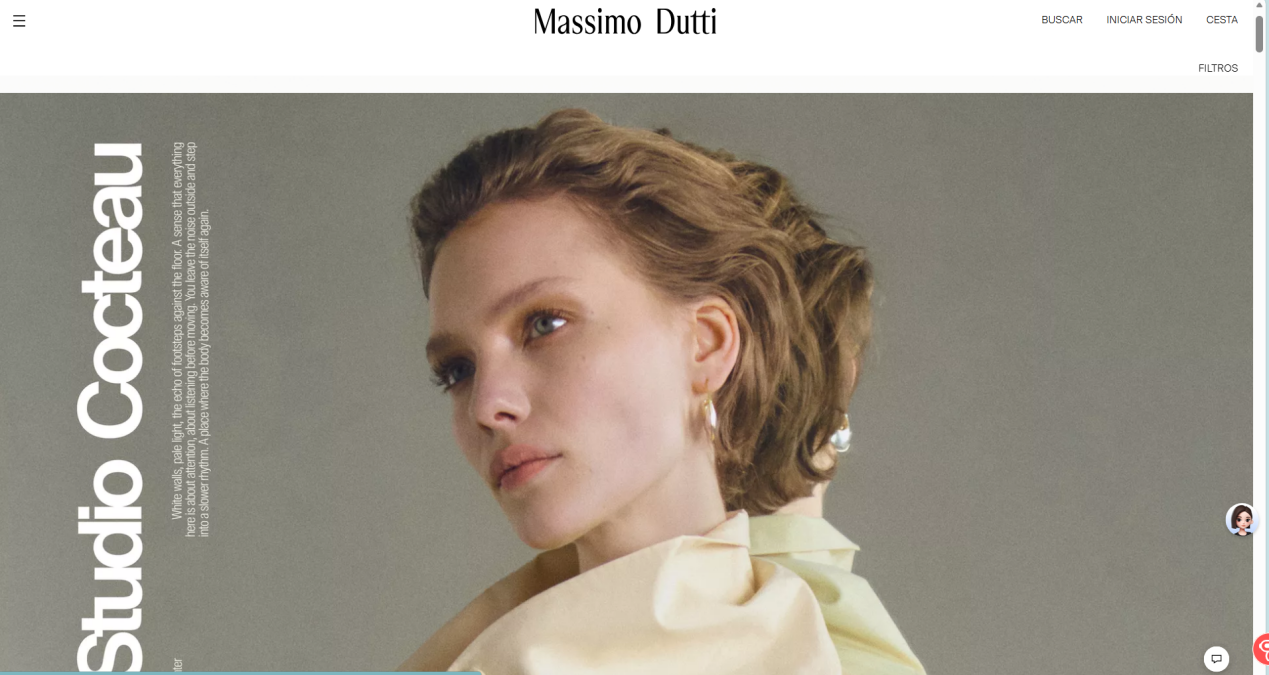
详情页左侧大图是需要保存的主图。人工 SOP 中会查看图片名称并下载保存;脚本会进入对应详情页,提取图片名称,去掉横杠及后续数字,并保存到固定输出目录。
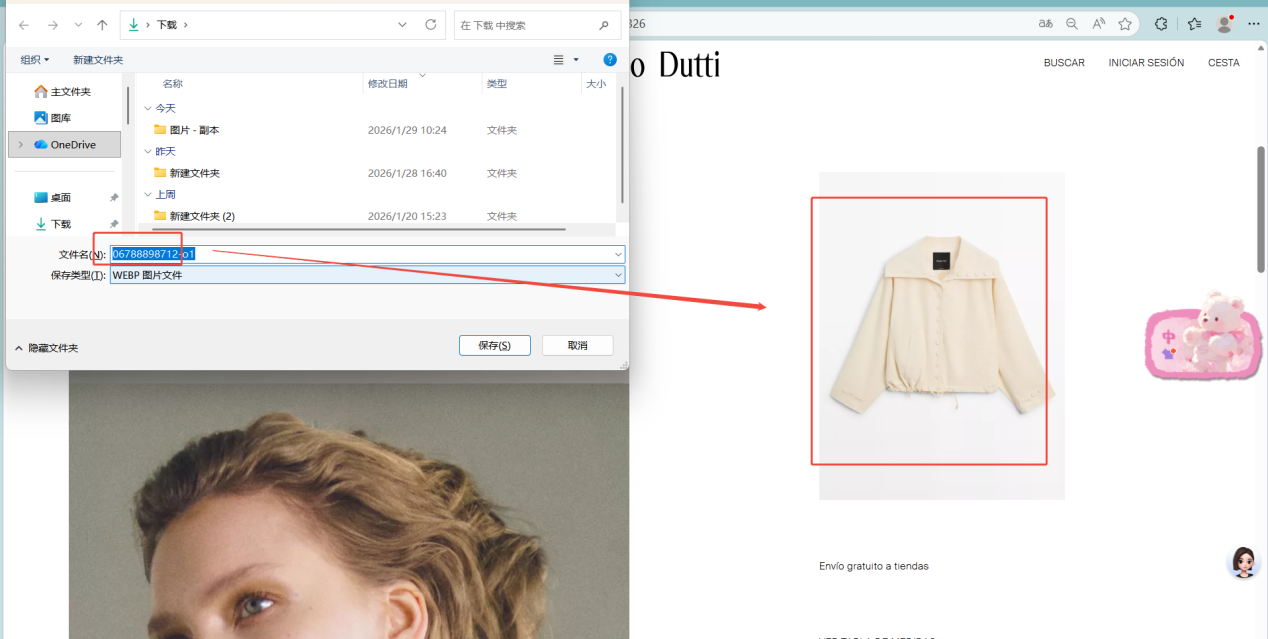
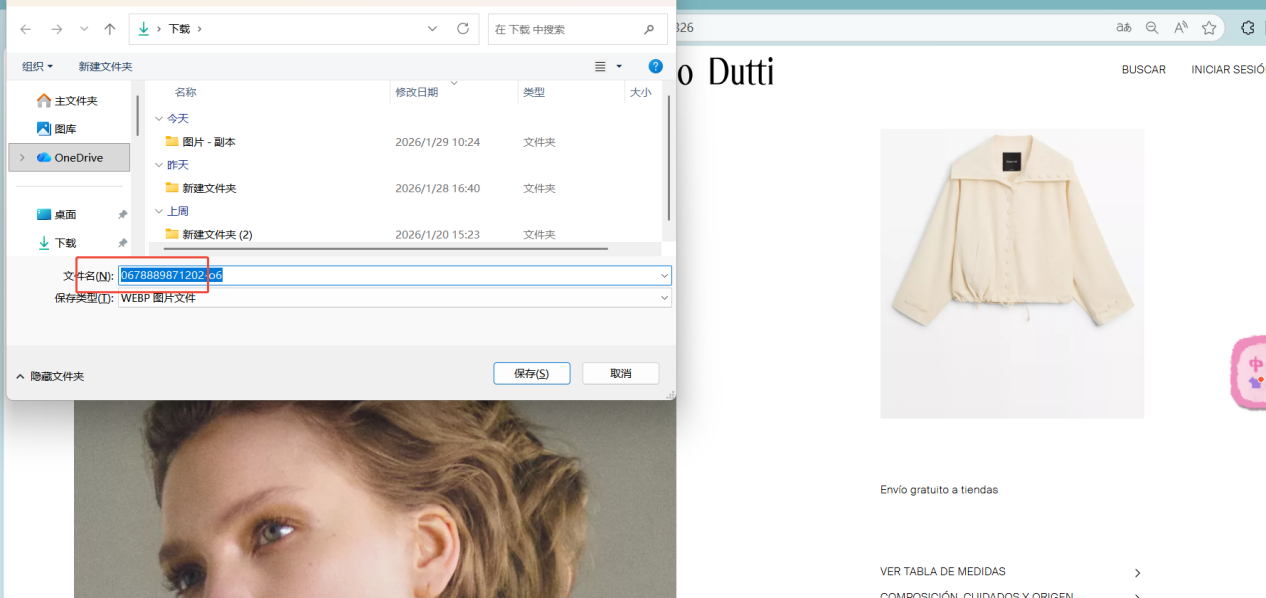
人工需要把右侧搭配商品逐个复制到天猫后台搜索。自动化实现中,我没有直接爬天猫后台,而是读取已有“天猫全店表”,根据官网货号生成 MCC 后匹配商品 ID,稳定性更高。
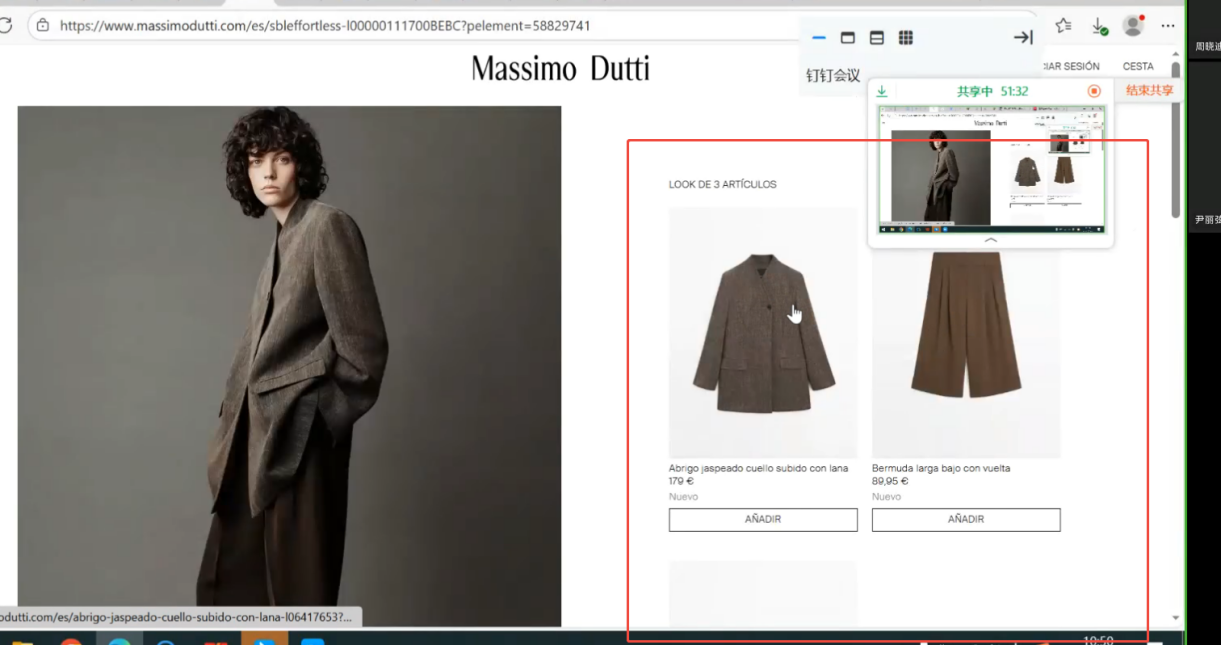
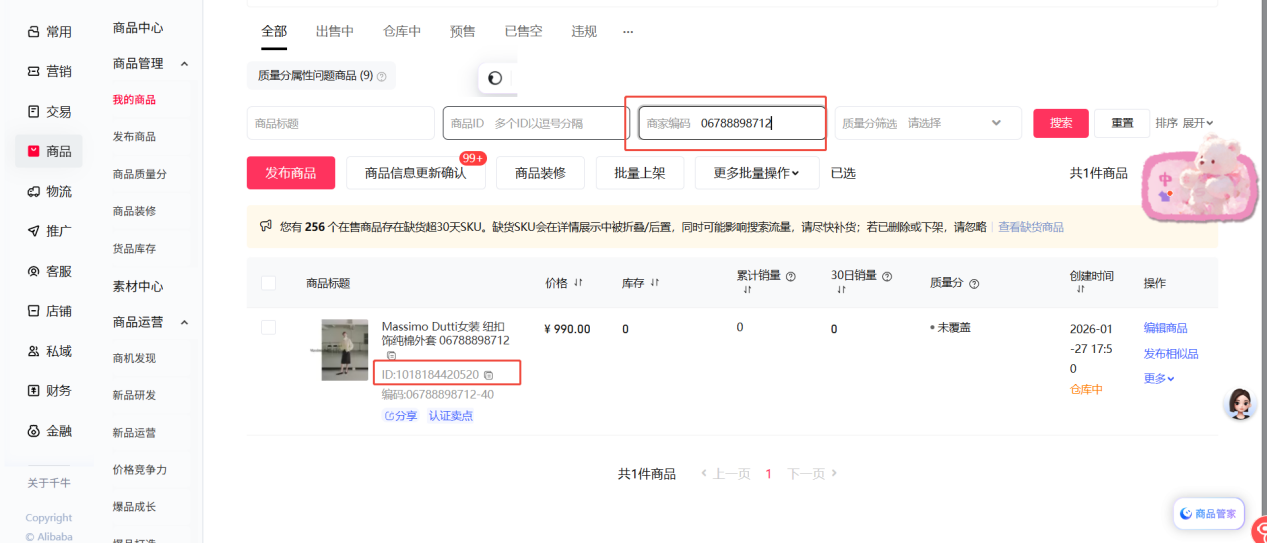
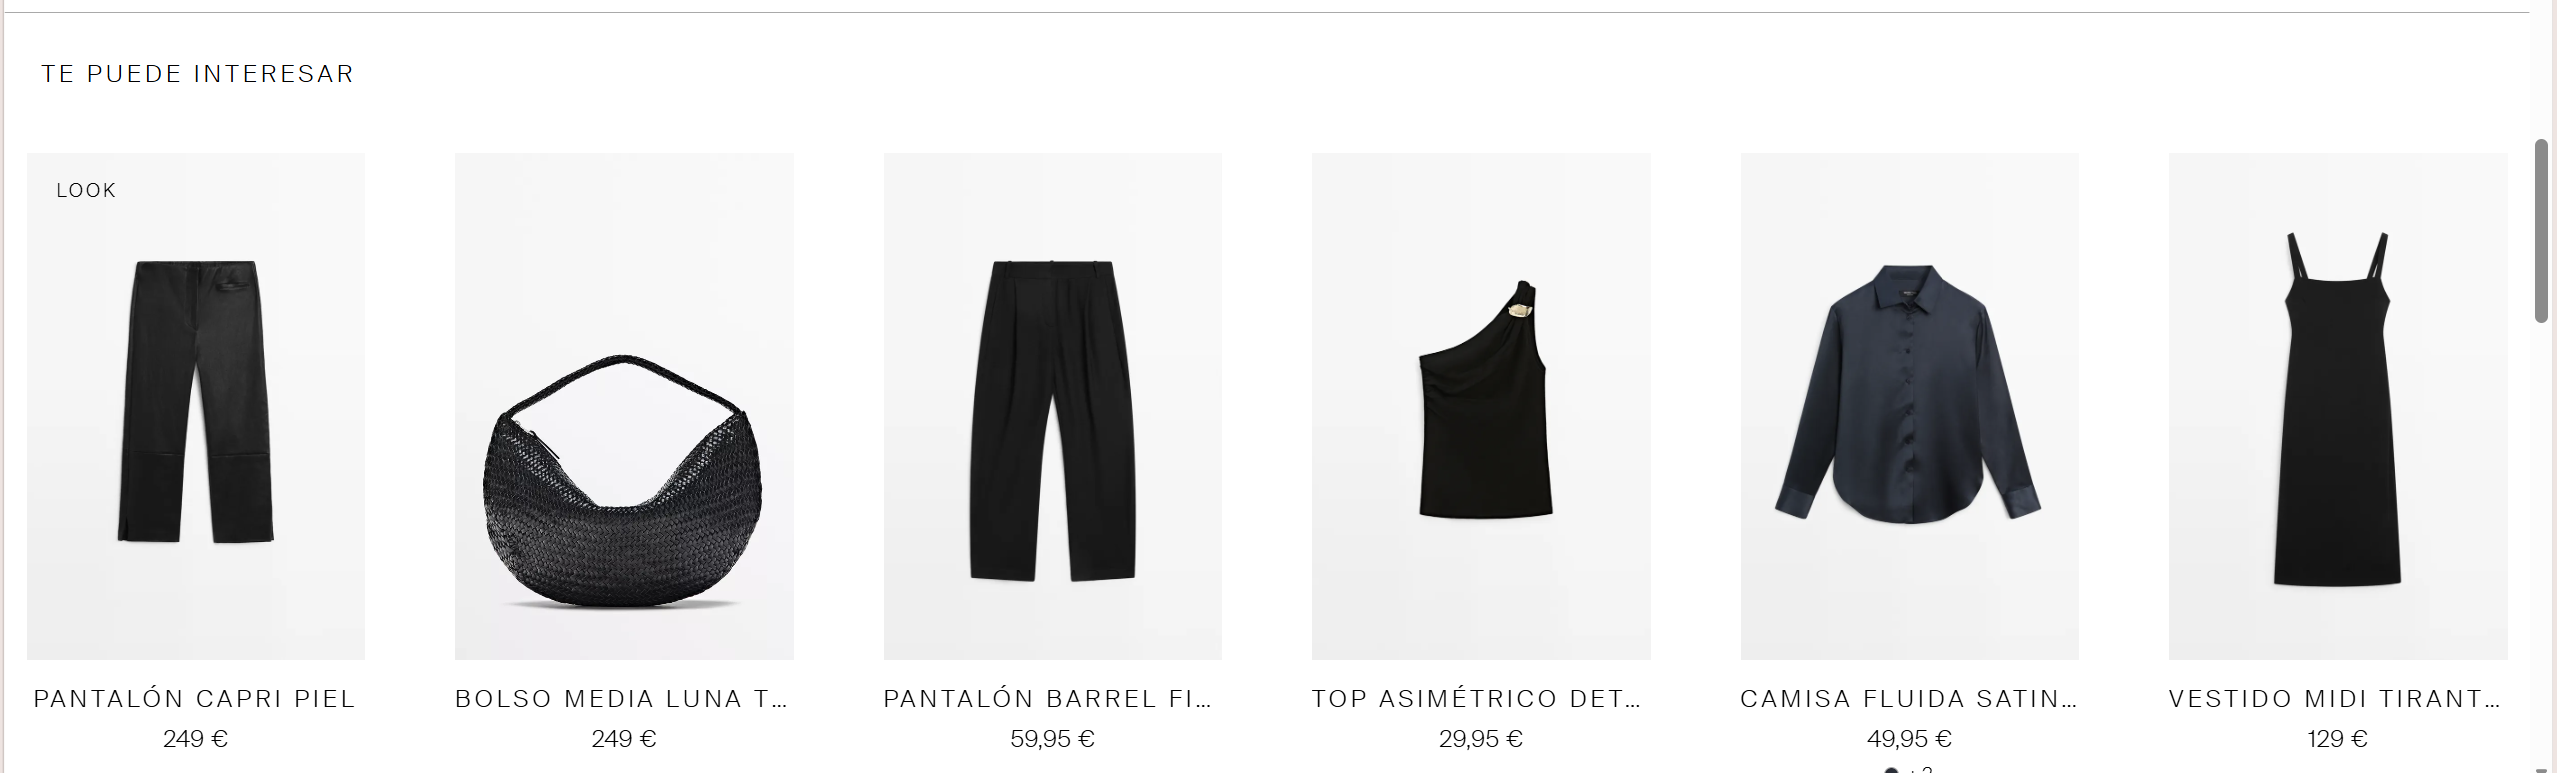
官网详情页下方会出现推荐区,例如“可能会感兴趣”。这些不是目标内容,需要过滤。最终表格一行代表一组“主图 - 搭配商品”关系;若一张主图对应多个商品,则生成多行。
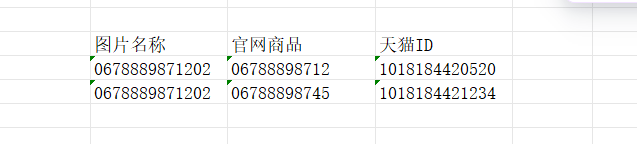
结果表将女装和男装合并在同一张表内,女装在上、男装在下。运营侧可以直接继续核验、上传或维护商品信息。